NO.01 · 2026 · 10
AI MV 工厂:从一首歌到一支成片
歌是 AI 写的,画面是代码一帧一帧画的,我负责挑和改 · 约 4 分钟读完
这半年玩得最开心的一件事:用 AI 做了四支音乐 MV。歌和角色是 AI 生成的,画面是我用 Python 一帧一帧画出来的。做下来发现,「让 AI 生成」反而是最简单的部分,真正花时间的是让歌、镜头、素材和字幕卡在同一条时间线上,并且改一处不会牵动全身。
四支成片
| 作品 | 风格 | 时长 | 怎么做的 |
|---|---|---|---|
| We Are Emerging | 从感知机一路讲到 Agent 的科技叙事 | 3:28 | 逐帧绘制,节拍网格卡点,群体模拟 |
| Sparkle Multimodal☆Nyan! | 偶像风 Kawaii Cyber-Pop | 约 3:10 | 逐拍时间表,歌词校准 |
| Notes to Myself | 安静的角色故事,6/8 拍 | 约 3:39 | 插画分层,差分转场,少量图生视频 |
| 未命名的星 | 奇幻叙事 | 约 3:58 | 16 个场景分层合成,稿纸上逐格写字 |
We Are Emerging 可以在这里看完整版。
几个模型一起干活
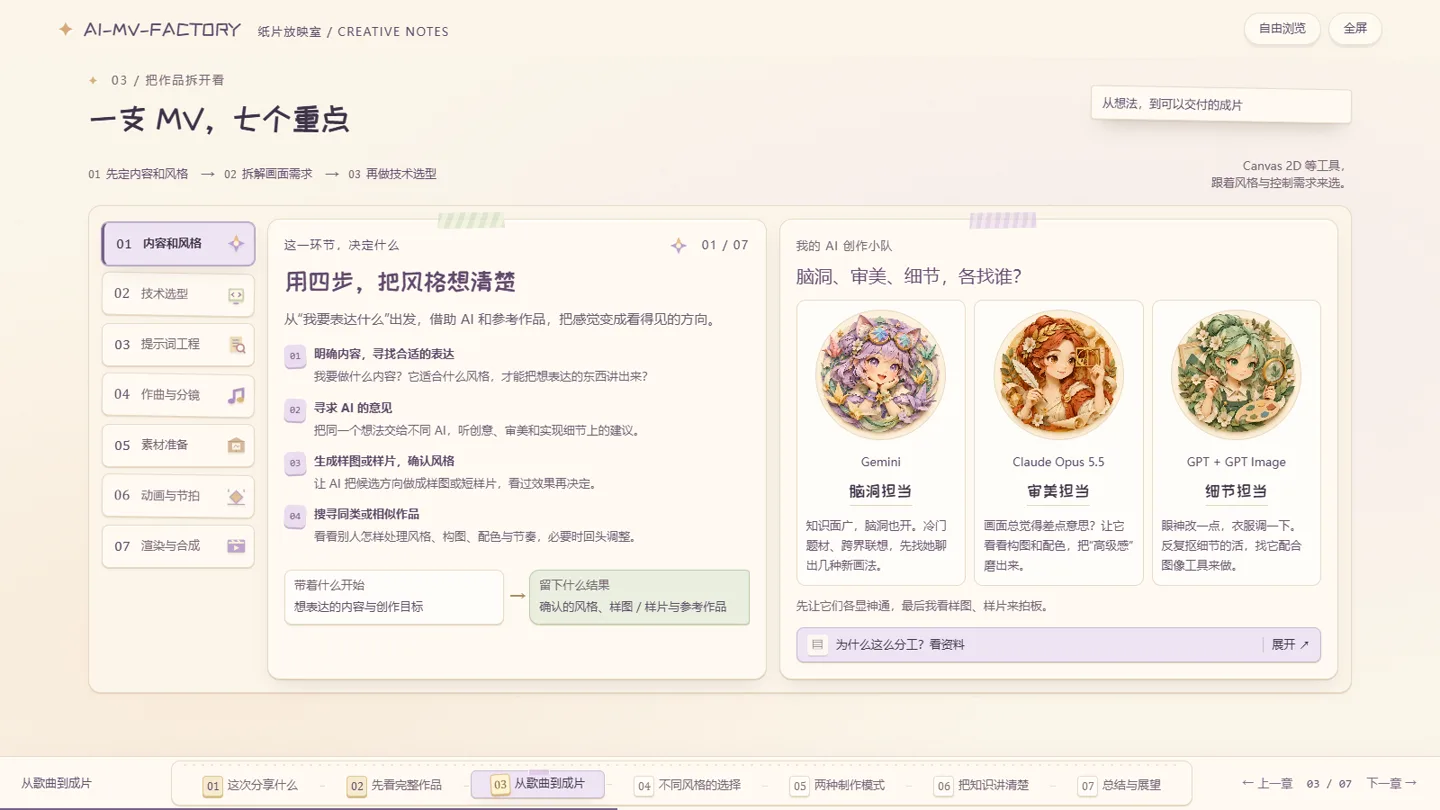
构思、写歌、出图、写代码都能丢给 AI,但每一步都得有人说一句「对,就是这个」。几条我自己摸出来的习惯:
- 先想拍什么,再想怎么拍。 内容和风格定了,再决定用 Canvas、Python 还是视频生成。
- 让不同模型干自己擅长的。 发散、审美、出图、写代码,各找各的。
- 先拍最难的那一小段。 多人同框、密密麻麻的名字、稿纸写字,先做样片,过了再做整支。
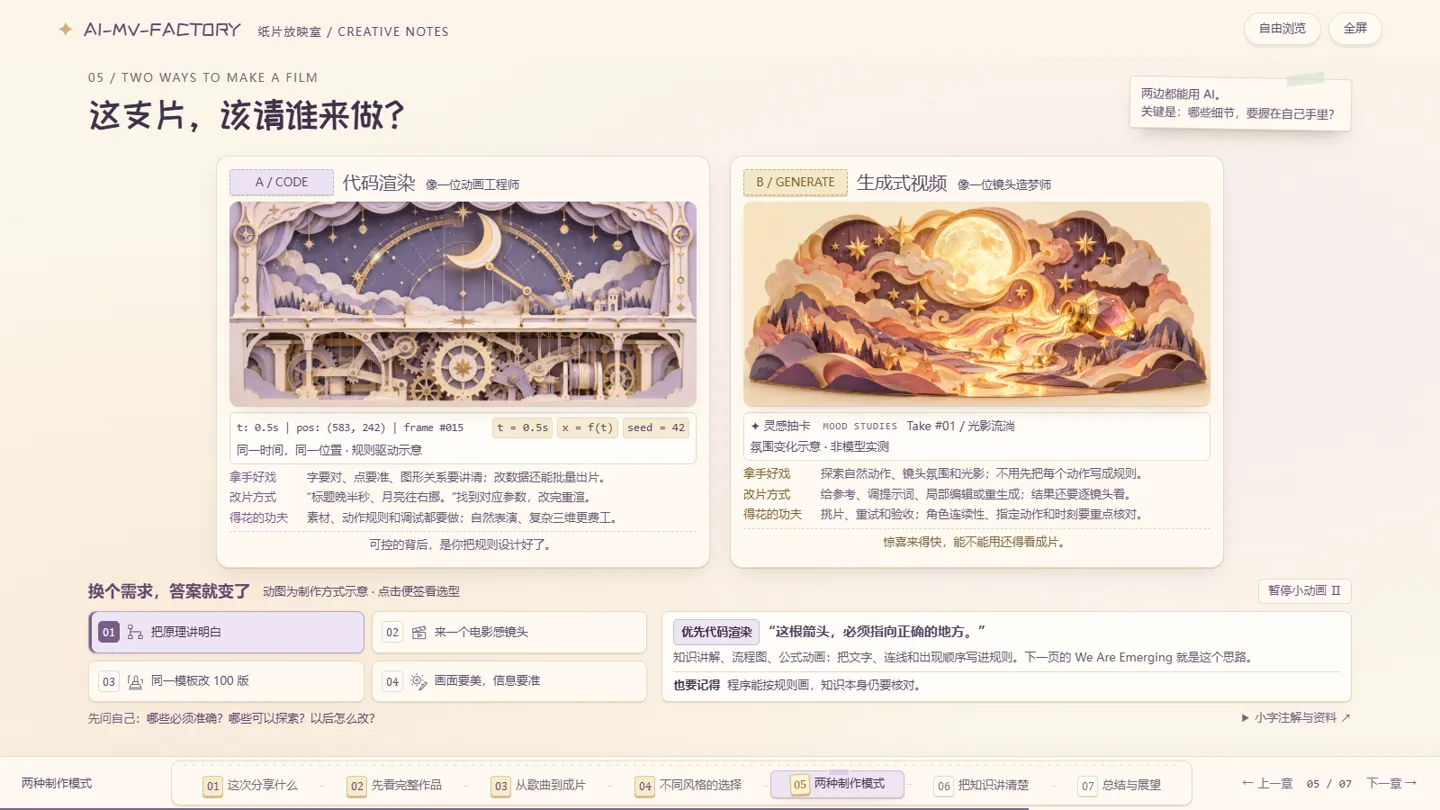
- 该死板的写成规则,该放飞的留给生成。 文字、时间、谁碰到谁交给代码,氛围交给模型。
AI 给的东西,也得自己量一遍
- 节拍。 Sparkle 的风格标签写着 160 BPM,我一量是 169.74,前面还有点变速。后来干脆做了一张逐拍时间表,所有动作都去查它。
- 歌词。 LRC 文件有的地方坏了,有的版本对不上,整体还偏晚一截。校准完歌词,跟着歌词走的动作也得一起挪,所以动作都按「唱到哪句」去查拍位,不在代码里写死时间。
- 素材。 有一次方案里把一张聊天截图当成了角色图。从那以后每张图我都先打开看一眼是干嘛的,再查人设、手脚、透明边和脚底的落点。
改一处,只动一处
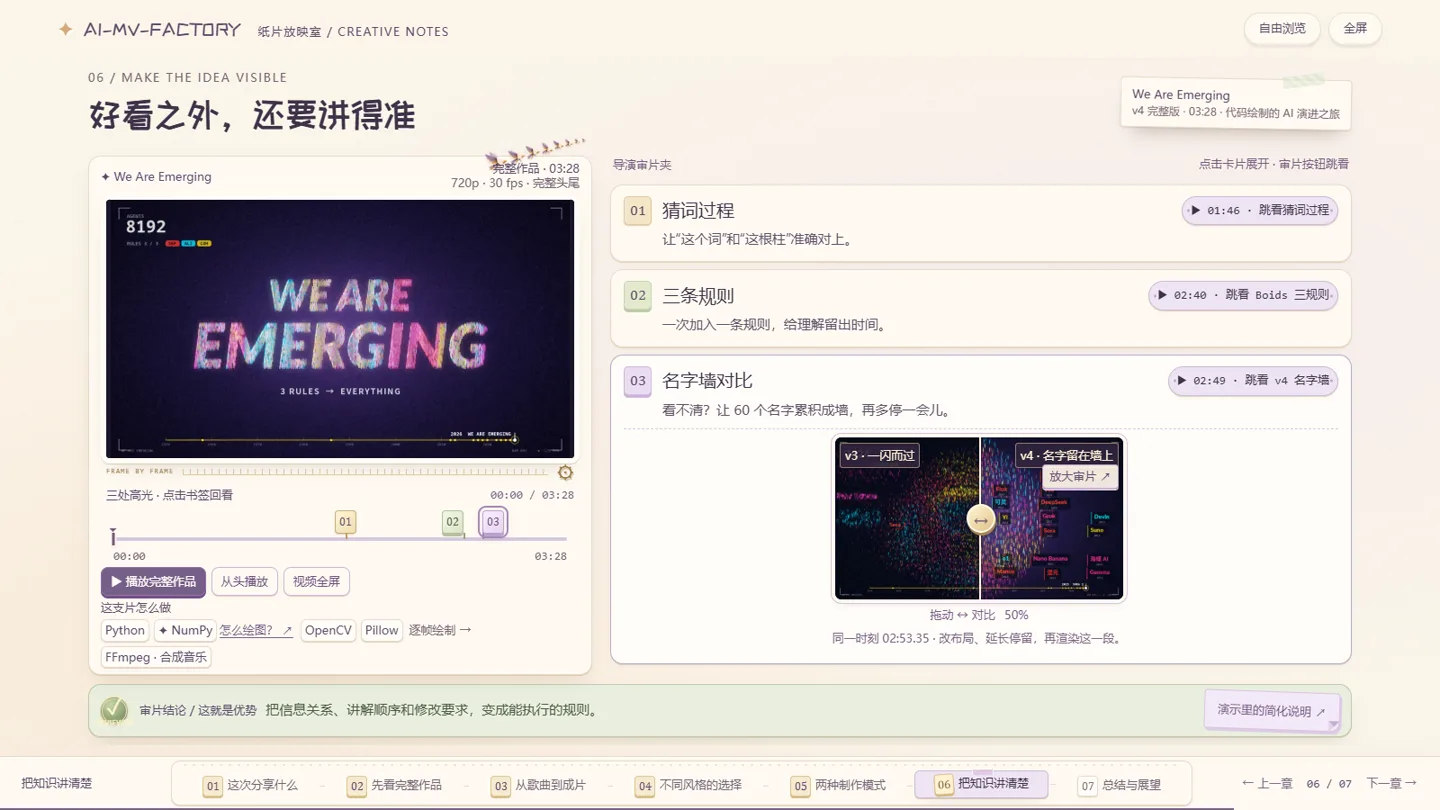
同样的时间、同样的素材,画出来就该一模一样。 We Are Emerging 结尾那群光标是用 boids 规则提前算好轨迹的,渲染时按帧去读。这样模拟可以依赖上一帧,成片却能随便跳到任何一秒单独重渲。
改片先圈范围。 拿到「这里不对」的反馈,先换算成哪个镜头、哪几帧,渲一帧确认改对了,再重渲那一段、看接缝。Notes 有一次 AI 说「改好了」,结果改的是另一个镜头。之后我把「代码改了」「文件出来了」「画面对了」当成三件事分别看。
看得清比动得多重要
- GPT 猜词那段一直在抖,字根本读不清。后来改成震一下马上停住,读字的时候画面是稳的,候选词跟着拍子换。
- 60 个名字的点名太快,谁也来不及看。第四版让名字先慢慢攒成一面墙,再在同一个重拍上一起放出来,出现快、停得久。
顺手讲了一场
做完之后整理成了一场 32 分钟的技术分享,配了七页离线 HTML,按「先看片 → 拆流程 → 聊取舍」往下讲。卡点演示直接拿视频的播放时间当唯一时钟,波形、拍线和歌词都跟着它走;复杂的动画全部提前渲好,整个文件夹拷走就能放。
做完最大的感受是:生成越容易,越要有清楚的时间规则和素材标准,不然越改越乱。
© 2026 袁天FEATURE / 01