AI 主播:Live2D 陪伴与直播控制台
谁先说、什么时候说、说过的话记不记 · 约 4 分钟读完
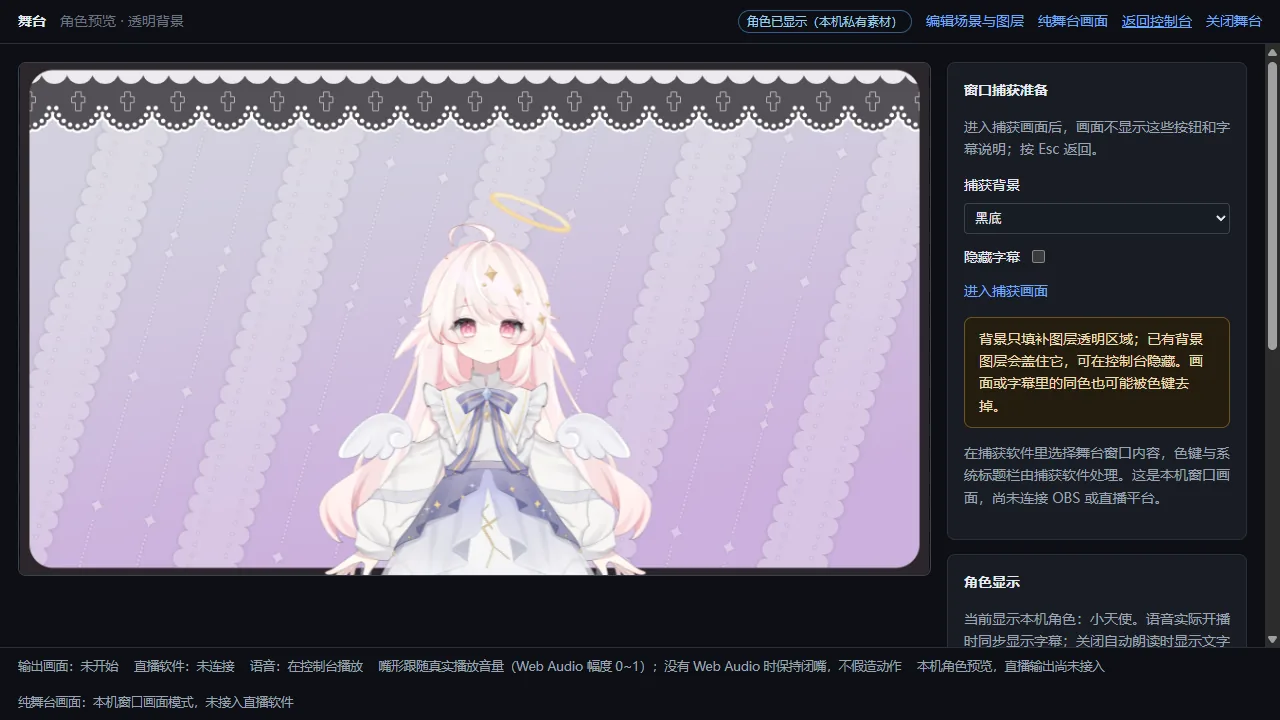
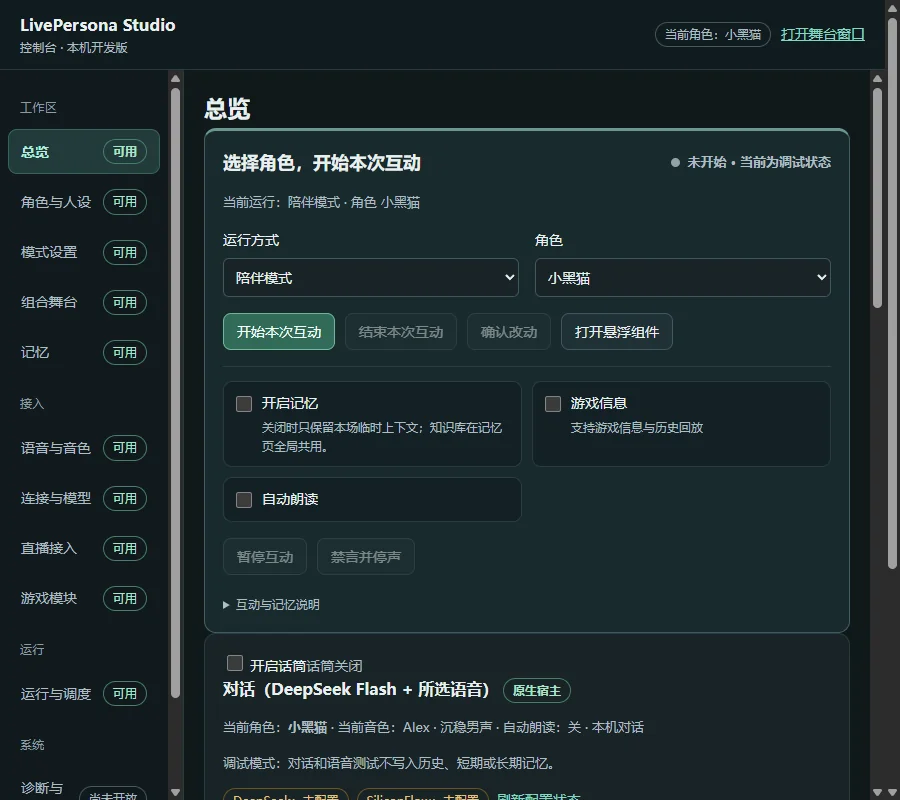
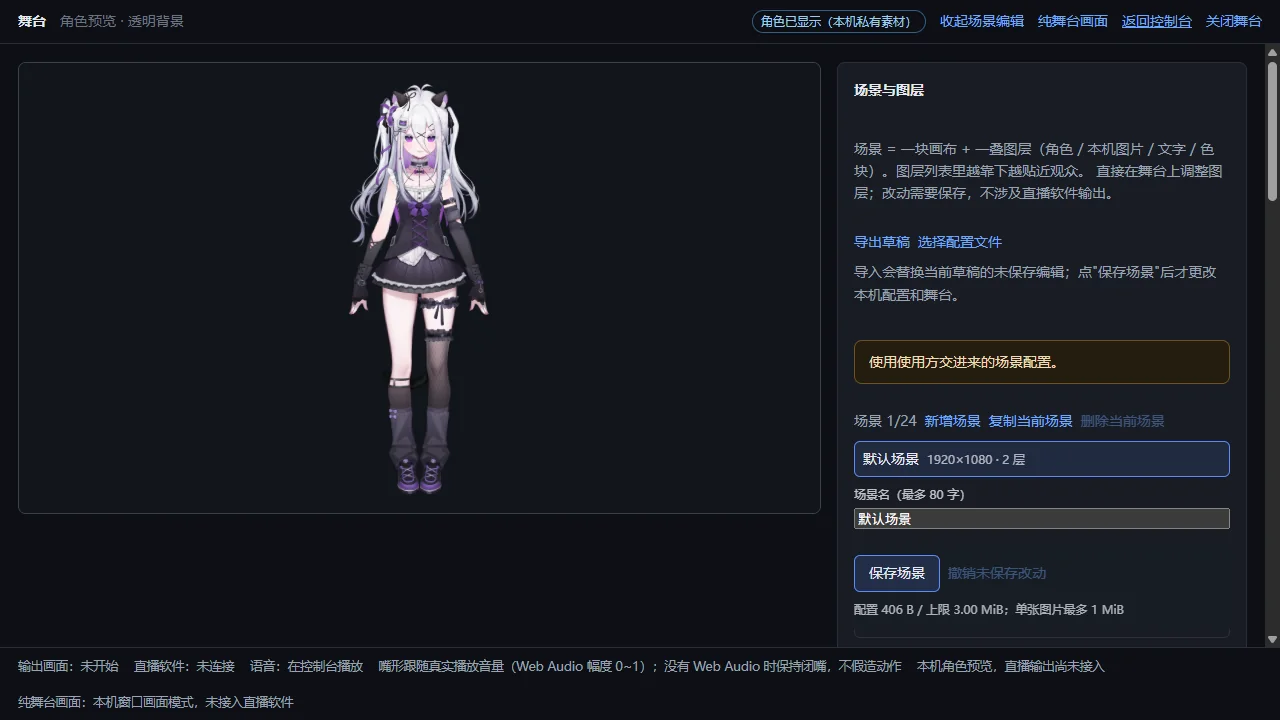
LivePersona Studio 是我给 AI 主播写的桌面控制台:控制台里管角色、模式、声音和记忆,舞台窗口放场景、角色和字幕,陪伴的时候还能开一只透明置顶的桌宠。模型没训练也没微调,花力气的地方在谁先说、怎么不冷场、什么该记住。
所有输入走一个入口
要处理的输入很杂:我在本地打的字、话筒识别出来的话、直播间弹幕、游戏状态,还有角色自己想搭话。它们都先进同一个调度入口,贴上来源,再决定谁先、要不要合并、这句该谁接。
- 我说话优先。 直播时勾上「用户加入」,我的输入排在弹幕前面。
- 弹幕每 25 秒攒一批再交给模型;只是有人进场、人气变了,就不回。
- 主动搭话从上一句播完、或者最后一条新消息开始计时,默认 15 秒,5 到 180 秒可调。
- 过期的回复直接扔掉。 清空、换角色、取消之后才回来的结果,不进队列。
开「分身」可以让两个角色同台。点名谁就谁回答;普通问题主角色答,另一位最多补一句。两人共用一条语音队列,不会抢着说话。对方说的话会带着身份传过来当参考,不会被当成用户说的,也不会记成自己的经历。
别冷场
直播里最尴尬的是开口前那几秒空白。所以回复超过 30 字时,先切出第一句短的(最多 30 字)马上合成开播,后面的边播边准备,每段最多 60 字。
音频永远只有一段在播、一段候着,再多最多一条文字回复排队等合成。上一条回复的最后一段开始合成了,才把这期间攒下的输入合起来问下一轮模型;新回复也要等前一条合成完,不会把正在说的话打断。字幕和表情跟着真正开始播的那一段走,不跟生成完成的时间走。
出错时:网络、超时、限流、5xx 自动重试两次;密钥、权限、配置不对就直接提示。语音只重试失败的那一段,播过的不再播;重试用完就留下文字,主动搭话也停掉,不会自己没完没了地开新一轮。
四层记忆
| 层 | 放什么 | 怎么写进去 |
|---|---|---|
| 当场上下文 | 最近 20 轮 | 自动,结束互动就清空 |
| 短期记忆 | 当场早些时候的压缩版 | 自动压缩,界面上能看压得好不好 |
| 长期记忆 | 每个角色陪伴、直播各一份 | 先变成待处理条目,我批准了才算数 |
| 知识库 | 所有角色共用 | 手动导入编辑,按关键词取 |
没点「开始本次互动」就当是在调试,说什么都不进记忆。不然调提示词时随口说的话,会变成角色以后的「回忆」。为什么这么分,写在《Agent 记忆分层》里。
工具默认关着
模型能看屏幕、能联网搜索,但默认都是关的,按模式开:
- 看屏幕只在陪伴时能用,浏览器、当前应用、整个屏幕,每轮加起来最多看一次,不会一直盯着,也不翻进程和浏览记录。直播时没有这个权限。
- 联网搜索只用来查拿不准的事,每轮最多一次、最多五条结果。搜回来的东西只当参考,里面写的指令不照做;搜不到就说不知道。
- 云端密钥只放在 Rust 那一层,用 Windows DPAPI 加密,前端碰不到。提示词预览和真正发出去的用同一个组装函数,看到的就是发出去的。
现在到哪了
在我自己电脑上已经能用:单文件包解压就能跑,自带三个本地音色和话筒识别,OBS 能采到舞台和桌宠。B 站直播间连上了,但还没真正开过一场带弹幕的长直播,这是下一步要做的;再往后想让它边直播边玩游戏。
技术栈是 Tauri 2、Rust、React/TypeScript,代码三万来行,测试文件 72 个。
做下来最大的体会:AI 主播难的不是让模型说得好听,而是谁在什么时候说、凭什么这么说、说错了能不能查回来。